blog
Hy3 của Tencent — model 295B chạy với chi phí của model 21B
Hy3 có 295 tỷ tham số nhưng mỗi token chỉ chạy qua 21 tỷ. Kiến trúc MoE, điểm benchmark đặt cạnh GLM-5.2, giá sau khi hết bản free, và việc nào nên giao cho nó.
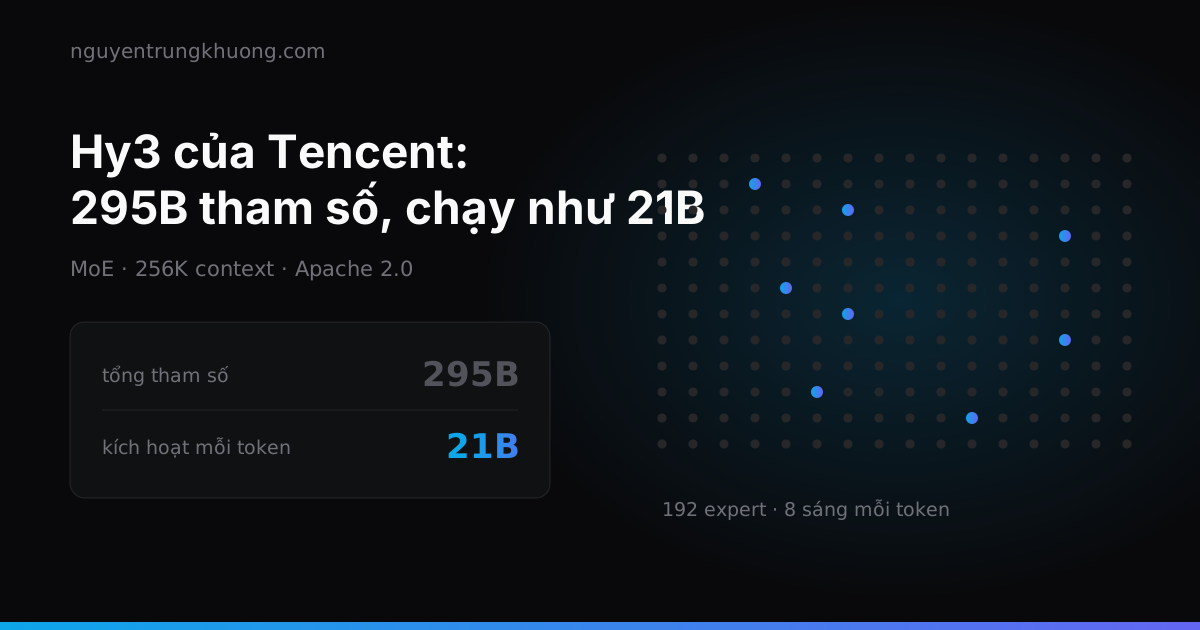
Tencent phát hành Hy3 ngày 6/7/2026 dưới giấy phép Apache 2.0, sau bản preview hồi cuối tháng 4. Con số gây chú ý là 295 tỷ tham số. Con số đáng quan tâm hơn: mỗi token chỉ đi qua 21 tỷ trong số đó.
Hai thứ quyết định việc có nên dùng Hy3 hay không là chi phí mỗi token và tỷ lệ bịa đặt 5,4%, không phải bảng benchmark.
295B tham số nhưng mỗi lần chỉ chạy 21B
Hy3 là kiến trúc Mixture-of-Experts. Model có 192 expert, mỗi token được bộ định tuyến đẩy qua 8 expert phù hợp nhất thay vì toàn bộ mạng. Phần còn lại nằm im.
Vài thông số cụ thể: 80 layer cộng một layer MTP 3,8 tỷ tham số, 64 attention head theo cơ chế GQA với 8 KV head, hidden size 4096, từ vựng 120.832 token, cửa sổ ngữ cảnh 256K.
Benchmark Hy3 đặt cạnh GLM-5.2
Ở nhóm suy luận, Hy3 đạt 90,4 điểm GPQA Diamond, 72,0 ở USAMO 2026 và 90,0 ở IMOAnswerBench. Ở nhóm lập trình: 78,0 trên SWE-Bench Verified, 75,8 trên SWE-Bench Multilingual, 71,7 trên Terminal-Bench 2.1.
Nhưng đặt cạnh GLM-5.2 thì bức tranh khác hẳn:
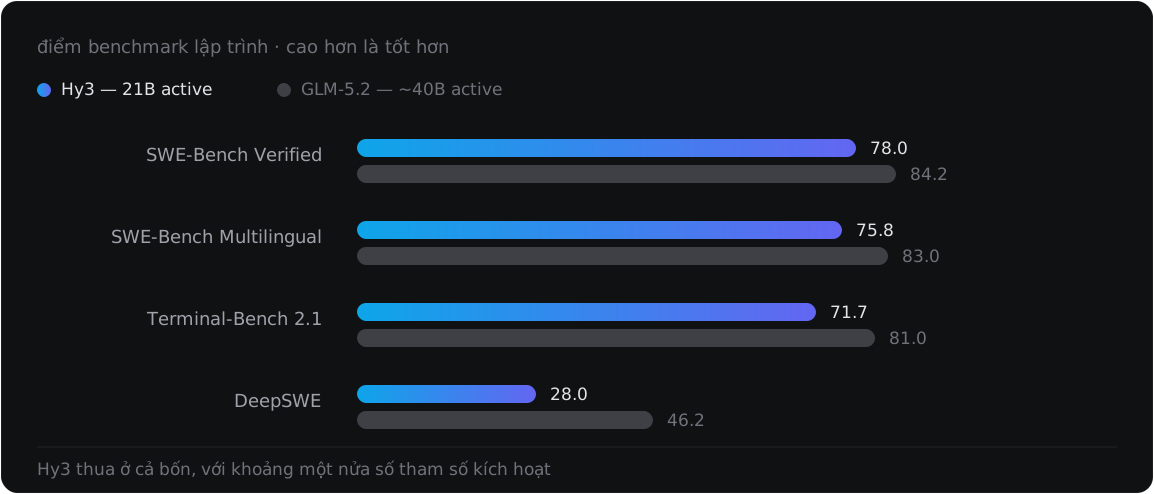
Hy3 thua cả bốn, riêng DeepSWE thua rất xa. Đổi lại, GLM-5.2 có khoảng 744 tỷ tham số tổng và ~40 tỷ tham số kích hoạt, gần gấp đôi Hy3 ở phần thực sự tốn tiền.
Cách đọc đúng là Hy3 cho mức hiệu năng trên chi phí tốt, không phải Hy3 mạnh nhất. Trong một bài đánh giá mù có 270 chuyên gia tham gia với 312 lượt so sánh hợp lệ, Hy3 được 2,67/4 so với 2,51/4 của GLM-5.1, hơn nhưng không cách biệt.
Một lưu ý về toàn bộ số trong mục này: chúng do Tencent tự công bố. Trong bảng gốc, những ô có dấu sao là điểm Tencent tự chạy lại cho model của đối thủ thay vì lấy số hãng kia công bố, và cả bốn ô GLM-5.2 ở nhóm lập trình đều có dấu sao đó. Bài đánh giá mù cũng do chính đội nghiên cứu Tencent tổ chức và tuyển người chấm. Tới lúc viết bài chưa có đơn vị độc lập nào công bố đo đạc riêng cho bản chính thức.
Bản chính thức khác preview: MRCR, lỗi multi-turn, tỷ lệ bịa đặt
Phần lớn công sức giữa hai bản đổ vào độ ổn định chứ không phải điểm số benchmark, và đây mới là thứ ảnh hưởng tới việc dùng thật:
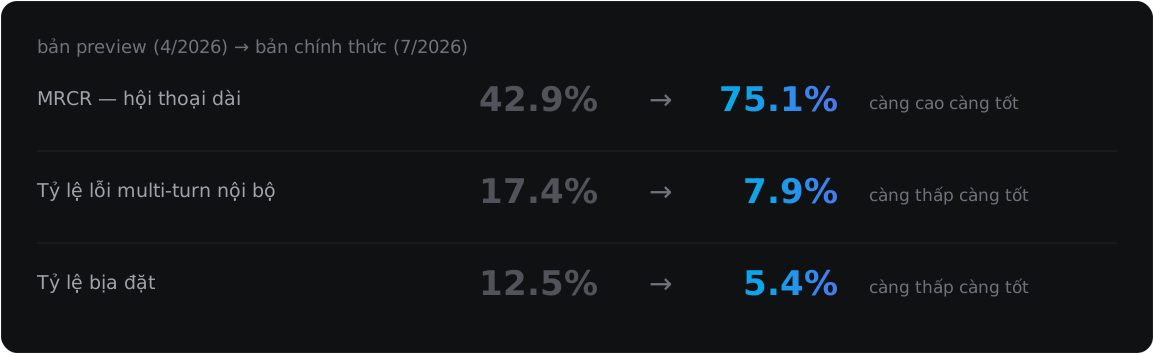
Tỷ lệ bịa đặt giảm từ 12,5% xuống 5,4% là con số tôi để ý nhất. 5,4% nghĩa là cứ khoảng hai mươi câu trả lời thì có một câu sai mà nghe rất thuyết phục.
Việc tôi sẽ giao cho Hy3
Nguyên tắc chung: giao những việc mà tôi kiểm chứng được kết quả trong vài giây.
- Dịch và tóm tắt tài liệu kỹ thuật dài, sai thì đọc bản gốc là ra ngay
- Viết bản nháp đầu tiên cho mô tả sản phẩm, email, nội dung trang dịch vụ
- Giải thích một đoạn code lạ, một thư viện chưa dùng bao giờ
- Sinh dữ liệu mẫu, viết script vặt, chuyển đổi định dạng
- Rà soát một đoạn code tìm lỗi rõ ràng, trước khi tự đọc kỹ
Cửa sổ 256K token hợp với việc đọc cả một file log dài hoặc toàn bộ tài liệu API của bên thứ ba trong một lượt. Hồi làm tích hợp API đồng bộ KiotViet, phần tốn thời gian nhất là đọc tài liệu để hiểu đúng ngữ nghĩa từng trường, đúng loại việc nên đưa cho model rẻ và nhanh.
Việc tôi không giao cho Hy3
Kiến trúc hệ thống, quyết định công nghệ, và bất cứ thứ gì đi thẳng ra production mà không có người đọc lại.
Vấn đề không nằm ở chỗ Hy3 kém. 5,4% tỷ lệ bịa đặt là con số đủ thấp để bạn mất cảnh giác và đủ cao để một trong hai mươi lần bạn dính. Với những quyết định mà cái sai chỉ lộ ra sau vài tuần, tỷ lệ đó không chấp nhận được.
Điểm DeepSWE 28,0 cũng nói một điều cụ thể: các tác vụ lập trình dài hơi, nhiều bước, tự sửa lỗi không phải chỗ mạnh của Hy3.
Hy3 miễn phí tới bao giờ?
Nhiều bài viết trên mạng xã hội đang hứa hẹn hạn mức khổng lồ, nên phần này cần con số chính xác.
Hy3 có mặt trên OpenRouter ở cả bản trả phí lẫn bản :free. Bản miễn phí đúng là 0 đồng mỗi token, nhưng giới hạn theo số lượt gọi, không theo token: 20 lượt/phút, 50 lượt/ngày với tài khoản chưa từng nạp tiền, và 1.000 lượt/ngày khi đã nạp từ 10 USD. Đây là hạn mức chung cho mọi model :free, tính trên tài khoản chứ không riêng Hy3. Không có "200 triệu token mỗi ngày" nào ở đây. Con số đó đến từ việc nhân hạn mức lượt gọi với độ dài ngữ cảnh tối đa, một phép tính không phản ánh cách dùng thật.
Giá niêm yết của bản trả phí, đọc ngày 23/7/2026: 0,1288 USD mỗi triệu token đầu vào và 0,5336 USD mỗi triệu token đầu ra. Bản :free tới nay vẫn còn, nhưng nó là chương trình quảng bá nên có thể tắt bất cứ lúc nào mà không báo trước.
Gọi thử Hy3 trong năm phút
Endpoint của OpenRouter tương thích OpenAI, nên phần lớn SDK chỉ cần đổi baseURL:
const res = await fetch('https://openrouter.ai/api/v1/chat/completions', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.OPENROUTER_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
    model: 'tencent/hy3',
    reasoning_effort: 'low', // no_think | low | high
    messages: [{ role: 'user', content: 'Tóm tắt tài liệu sau trong 5 gạch đầu dòng: ...' }],
  }),
})
Tham số reasoning_effort là thứ đáng nghịch nhất. Đặt no_think cho việc dịch, tóm tắt, đổi định dạng: nhanh hơn hẳn mà chất lượng không đổi. Chỉ bật high khi câu hỏi thật sự cần suy luận nhiều bước.
Tự host Hy3 thì cần gì
Trọng số mở hoàn toàn theo Apache 2.0, tải về từ Hugging Face. Cấu hình tham chiếu là 8 GPU loại H20-3e hoặc card có bộ nhớ lớn hơn, chạy ở độ chính xác BF16; có sẵn bản FP8 nếu thiếu VRAM.
vllm serve tencent/Hy3 \
  --tensor-parallel-size 8 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 2 \
  --tool-call-parser hy_v3 \
  --reasoning-parser hy_v3 \
  --enable-auto-tool-choice
Layer MTP chính là chỗ dùng cho speculative decoding: nó đoán trước nhiều token mỗi bước, đổi lại tốc độ sinh cao hơn. SGLang cũng hỗ trợ tương tự.
Với một xưởng làm website, tự host không có ý nghĩa kinh tế. Tám GPU loại đó đắt hơn nhiều năm tiền API. Giá trị của giấy phép Apache 2.0 ở đây là bạn có thể rời đi nếu nhà cung cấp đổi giá hay đóng cửa, không phải bạn nên tự dựng ngay.
Hy3 đáng dùng khi nào
Hy3 không phải model mạnh nhất hiện có, và Tencent cũng không quảng cáo như vậy. Nó là model mở tốt nhất trong nhóm chi phí thấp ở thời điểm này: kiến thức rộng, ngữ cảnh dài, tiếng Anh chắc, tiếng Việt dùng được, giấy phép sạch.
Cách dùng hợp lý là để Hy3 gánh phần việc nhiều mà nhẹ (dịch, tóm tắt, nháp, giải thích, script vặt) rồi dành model đắt tiền cho phần thật sự khó.
Bài viết liên quan
tất cả bài viết → Viết CLAUDE.md đúng chuẩn: bốn nhóm quy tắc và giới hạn thật của Claude CodeCLAUDE.md hoạt động tốt khi chia thành bốn nhóm rõ ràng: lệnh, quy tắc, kiến trúc theo path, và cách mở rộng khi dự án lớn lên. Hướng dẫn viết từng nhóm đúng giới hạn kỹ thuật thật của Claude Code, kèm ví dụ chạy được.đọc tiếp →
 Loop engineering: thôi prompt agent, đi thiết kế cái vòng lặp prompt nóDựng một vòng lặp cho agent giờ mất mười lăm phút. Phần khó là nhét vào trong đó một thứ dám nói "không". Năm nước đi của một vòng, năm kiểu hỏng, và vòng lặp thật của site này đang đi được nửa đường.đọc tiếp →
 Gemini 3.6 Flash trên Antigravity CLI — ít hơn 17% output tokenGoogle thay Gemini CLI bằng Antigravity CLI, và 3.6 Flash là model đáng để mặc định trong terminal. Cách chọn model bằng agy, chạy headless, và tính tiền cho một lượt agent.đọc tiếp →
 Lộ trình 12 tháng thành AI Engineer — không cần bằng Computer ScienceSáu phase, mỗi phase ship một thứ chạy được: Python, LLM API, RAG, agent, eval và portfolio. Lộ trình cho dev muốn chuyển sang làm AI, kèm phần thị trường Việt Nam.đọc tiếp →