blog
Tối ưu subagent Claude Code: cắt 40-78% chi phí mỗi lượt gọi implementer
Subagent đắt vì mỗi lần khởi động nạp hàng chục nghìn token luật và skill, rồi lặp lại qua hàng chục turn. Tôi đo bằng transcript, thay bằng agent riêng, rồi đối chiếu qua 3 lượt chạy subagent-driven-development thật.
- Ngày đăng
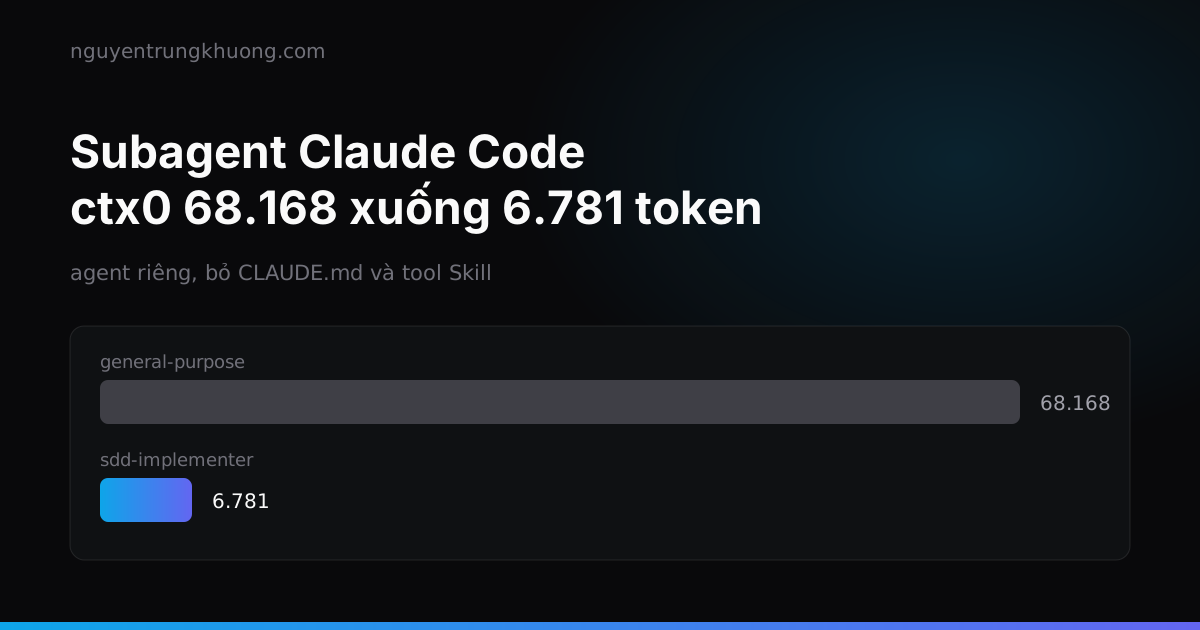
Subagent Claude Code đắt vì 3 thứ nhân với nhau: context nạp lúc khởi động, số turn, và model chọn lúc gọi. Prompt giao việc gần như không đáng nói. Một agent riêng cắt context khởi động từ 68.168 xuống 6.781 token trong phép đo trên repo nháp; ở 3 lượt chạy thật, chi phí mỗi lượt gọi implementer Sonnet giảm 40-78% so với mốc cũ cùng vai.
Subagent đắt ở context khởi động, không ở prompt giao việc
Tôi chạy khoảng 20 phiên Claude Code song song trên một máy Mac, mỗi phiên một dự án. Plugin superpowers bật mặc định, nên việc dài đi theo skill subagent-driven-development (SDD): phiên chính điều phối, mỗi task một implementer subagent mới, một reviewer cho từng task, fix loop có trần vòng. Hết plan thì final review cả nhánh bằng model mạnh nhất. Một turn là một lượt hỏi đáp giữa subagent với model và tool.
Số đo 7 ngày cho agent general-purpose, chỉ đọc usage trong transcript:
| Model | Lượt gọi | TB turn | Context khởi động | Token đọc từ cache |
|---|---|---|---|---|
| Opus | 249 | 41 | ~60k | 1,54 tỷ |
| Sonnet | 352 | 25 | ~65k | 1,13 tỷ |
Một mẫu khác gồm 10 subagent cho context khởi động (từ đây gọi ctx0) trung bình ~83k token, trong khi prompt giao việc chỉ 1-2 nghìn ký tự. Phần còn lại là thứ subagent tự nạp, đo bằng ký tự:
CLAUDE.mdcấp user, ~11,5k ký tự.AGENTS.mdcủa repo, phần lớn nhất: một repo có file 95k ký tự, tương đương ~50k token. Repo của tôi kéo file này vào qua dòng@AGENTS.mdtrongCLAUDE.md.- Danh sách skill, ~25k ký tự.
- Output hook
SessionStart, danh sách agent, định nghĩa tool.
Mỗi turn subagent đọc lại context đó cộng phần đã tích luỹ (tool output, các turn trước), trung bình 130-150k token mỗi turn.
Cache read phình số token thô, cost_units mới so được
Token đọc từ cache chỉ tính 0,1 lần giá input. Con số 1,54 tỷ nghe đáng sợ nhưng phần lớn là cache read rẻ. Thứ nhân chi phí là số turn và tool output dồn qua từng turn. Nên tôi đo bằng chi phí quy đổi, đơn vị là giá input gốc của model:
cost_units = input + 1.25 × cache_write_5m + 2 × cache_write_1h
           + 0.1 × cache_read + 5 × output
So cost_units trong cùng một model. Đừng kết luận từ token thô.
Đo ctx0 và cost_units từ transcript
Mỗi subagent có transcript riêng ở subagents/agent-*.jsonl. ctx0 là input + cache_read + cache_creation của assistant message đầu tiên. File agent-*.meta.json cho biết loại agent, model và id lệnh gọi; nối id đó với lệnh gọi Agent ở transcript phiên cha để biết có ghi model hay không.
Để so từng cấu hình, tôi dùng một repo nháp chép luật của repo thật (không đụng repo thật) và chạy claude -p với phiên cha Sonnet, MCP rỗng (--strict-mcp-config). Phiên cha gọi đúng một subagent làm một việc cố định: đọc go.mod, trả 3 dòng. Mỗi cấu hình chạy 2 lượt, ctx0 của 2 lượt trùng nhau tới từng token. Danh sách skill có tới subagent hay không thì grep attachment skill_listing trong transcript, không hỏi model.
Bỏ CLAUDE.md và tool Skill: ctx0 giảm 93% trong phép đo
Repo nháp mang luật của repo có AGENTS.md 95k ký tự:
| Cấu hình | ctx0 |
|---|---|
general-purpose | 68.168 |
Agent riêng, tool hẹp, vẫn nạp CLAUDE.md | 55.437 (-19%) |
Agent riêng, omitClaudeMd: true, có tool Skill | 13.009 |
Agent riêng, omitClaudeMd: true, không tool Skill | 4.857 (-93%) |
| Explore built-in | 15.338 |
Explore tự định nghĩa, omitClaudeMd, không Skill | ~4,2k |
2 dòng giữa cho thấy danh sách skill nặng ~8k token và chỉ xuất hiện khi agent có tool Skill. Prompt SDD không gọi skill nào, nên bỏ tool này không mất gì.
Theo docs của subagent, frontmatter có omitClaudeMd (bỏ các file CLAUDE.md user, project, local khỏi context đầu), tools, maxTurns và effort. Docs ghi omitClaudeMd cần Claude Code v2.1.271 trở lên, và CLAUDE.md trong thư mục con vẫn được nạp khi agent làm việc với file ở đó. Agent implementer của tôi, rút gọn:
---
name: sdd-implementer
description: Implements one plan task from its brief file
model: sonnet
effort: high
maxTurns: 60
omitClaudeMd: true
tools: Read, Edit, Write, Bash, Grep, Glob
---
Reviewer chỉ có Read, Grep, Glob, Bash, không có Write hay Edit, trần 20 turn. Sau khi cài, probe cho ctx0 implementer 6.781 và reviewer 6.208, so với 68.168 ban đầu. Ở 2 lượt chạy thật, ctx0 cao hơn probe (10,9-11,8k); tôi chưa tách ra nguyên nhân.
Agent không còn nạp AGENTS.md, nên prompt giao việc phải nêu mục nào của AGENTS.md liên quan, theo tiêu đề, kèm file cần đọc. Agent liệt kê heading rồi chỉ đọc mục đó, không đọc cả file 95k ký tự.
Phần lớn chi phí Opus của subagent Claude Code đến từ việc chọn Opus thẳng lúc gọi
Chỉ 22% chi phí Opus 7 ngày đến từ lượt gọi không ghi model. Chỉ phần này đổi được bằng biến CLAUDE_CODE_SUBAGENT_MODEL, vì theo docs (từ v2.1.251), model chọn theo thứ tự: tham số model lúc gọi, rồi model trong frontmatter, rồi biến môi trường, rồi model phiên chính. Phần còn lại phần lớn là chọn Opus thẳng lúc gọi: SDD của một repo chiếm 52% chi phí Opus (implementer, reviewer và final review đều Opus), viết plan thêm 20%.
Explore built-in dùng model của phiên chính. Theo docs, khi phiên chính chạy Fable qua gói thuê bao, Explore chạy Opus. Muốn đổi thì định nghĩa một agent cùng tên Explore, nó đè bản built-in.
Luật chọn model theo vai tôi giữ lại:
- Implementer: Sonnet. Nâng lên Opus ở vòng 4-5 của fix loop hoặc với task kiến trúc.
- Reviewer: Sonnet, nhưng Opus khi diff đụng security, permission, concurrency hoặc migration dữ liệu. Reviewer là chốt chất lượng nên không hạ ở chỗ rủi ro.
- Final review cả nhánh: Opus.
CLAUDE_CODE_SUBAGENT_MODELđặt Sonnet làm mặc định. Tôi không dùng bản_FORCE(ép mọi subagent về một model) vì final review cần Opus.
Tôi không sửa file của superpowers (cập nhật upstream sẽ đè) và không đè general-purpose (mọi subagent khác sẽ mất CLAUDE.md). Tôi cũng không tạo agent theo vai nghiệp vụ: một thử nghiệm trước đó tốn ~2,4 lần token, và model tự giao đúng vai 0/5 lần.
3 lượt chạy thật: một hướng, chưa có A/B
Lượt 1 và 2 chạy ở cùng một repo Go có web, đêm 04/11. Lượt 3 chạy sau khi mọi phiên khởi động lại với cấu hình mới. Số đo bằng script đọc usage trong transcript. Task mỗi lượt khác nhau, nên coi số là một hướng.
Mốc để so là 7 ngày trước khi đổi cấu hình (tới 04/11 01:23 giờ máy), ở cùng repo, SDD cũ với general-purpose. Tôi tách mốc theo vai bằng cách đọc chữ trong mô tả và prompt giao việc. Đây là phân loại heuristic, khớp 251/252 lượt gọi Sonnet:
| Vai | Model | Lượt gọi | TB turn | ctx0 | cost_units mỗi lượt gọi |
|---|---|---|---|---|---|
| Implementer | Sonnet | 137 | 40,7 | 69,4k | 1,13M |
| Reviewer | Sonnet | 99 | 8,4 | 70,2k | 0,24M |
| Implementer | Opus | 41 | 71,0 | 71,1k | 2,27M |
| Reviewer | Opus | 44 | 24,5 | 67,9k | 0,78M |
| Final review | Opus | 25 | 37,7 | 70,2k | 1,06M |
cost_units mỗi dòng tính theo giá input của model dòng đó, nên không so được giữa dòng Opus và dòng Sonnet.
Lượt 1: 1 plan SDD 8 task, final review cả nhánh và một đợt sửa sau đó. Implementer Sonnet, reviewer Sonnet (Opus cho 3 task rủi ro: migration, gieo dữ liệu thật, ranh giới lộ dữ liệu), final review Opus.
| Vai | Lượt gọi | TB turn | ctx0 | cost_units mỗi lượt gọi |
|---|---|---|---|---|
| Implementer Sonnet | 9 | 19,2 | 10,9k | 0,25M |
| Reviewer Sonnet | 6 | 5,7 | 10,2k | 0,08M |
| Reviewer Opus | 3 | 7,3 | 10,2k | 0,12M |
Final review Opus (general-purpose, vẫn nạp luật) | 1 | 34 | 86,7k | 0,89M |
Implementer Sonnet so với mốc cùng vai: cost_units mỗi lượt gọi từ 1,13M xuống 0,25M (-78%), turn từ 40,7 xuống 19,2, ctx0 từ 69,4k xuống 10,9k. Reviewer Sonnet từ 0,24M xuống 0,08M (-67%).
Chất lượng lượt 1 (chưa có mốc chất lượng cũ để so): fix loop 0 vòng ở cả 8 task, không lỗi Critical hay Important. Final review Opus ra 8 lỗi Minor, 7 trong đó reviewer từng task đã báo trước; đợt sửa 6 lỗi và re-review xác nhận đủ.
Lượt 2: 5 luồng plan chạy song song bằng một workflow, mỗi luồng một worktree. Mỗi nhánh có final review, sau đó gộp tuần tự vào nhánh tích hợp và chạy cả bộ e2e.
| Vai | Lượt gọi | TB turn | ctx0 | cost_units mỗi lượt gọi |
|---|---|---|---|---|
| Implementer Sonnet | 18 | 24,2 | 11,8k | 0,33M |
| Reviewer Sonnet | 12 | 8,1 | 11,1k | 0,09M |
| Reviewer Opus (diff rủi ro) | 3 | 6,3 | 11,2k | 0,08M |
general-purpose Opus (final review, gộp nhánh, e2e) | 5 | 49 | 88,8k | 1,09M |
Implementer Sonnet: 1,13M xuống 0,33M (-71%), 27 lượt gọi implementer ở lượt 1 và 2 cộng lại.
Lượt 3: một phiên điều phối chạy 4-5 plan song song khoảng 5 giờ, sau khi mọi phiên khởi động lại với cấu hình mới. Tổng cộng 126 lượt gọi subagent, 56,9M cost_units; bảng dưới liệt kê 4 vai, 119 trong 126 lượt gọi.
| Vai | Lượt gọi | cost_units mỗi lượt gọi | Mốc cũ cùng vai |
|---|---|---|---|
| Implementer Sonnet | 45 | 0,68M (0,43M không tính 5 task chạm trần) | 1,13M |
| Reviewer Sonnet | 35 | 0,11M | 0,24M |
| Reviewer Opus (diff đụng bảo mật, concurrency) | 31 | 0,23M | |
general-purpose Opus (final review, re-review, 1 plan) | 8 | 1,01M |
Implementer Sonnet giảm 40% so với mốc 1,13M, và 62% nếu bỏ 5 task chạm trần (0,43M). Reviewer Sonnet giảm 54%. Các dòng Opus không có mốc cũ cùng vai để so. Mọi implementer và reviewer đều đi đúng agent gọn, khởi động ở ctx0 10-12k so với 70-90k trước đó, và mọi lượt gọi đều nêu model, dù luật chỉ là một đoạn trong CLAUDE.md, không cần hook ép.
Chỗ hỏng sau 3 lượt chạy: maxTurns, luật repo, gói diff
general-purpose Opus là điểm nghẽn tiếp theo. Ở lượt 2 nó chỉ chiếm 5 trong 38 lượt gọi nhưng 5,46M trong 12,8M cost_units (43%), vì vẫn nạp ~89k context luật mỗi turn. Tổng 12,8M cộng chéo Sonnet và Opus theo đơn vị giá gốc của từng model, nên tính ra tiền thì phần của Opus còn lớn hơn. Việc kế tiếp là một agent riêng cho final review và gộp nhánh.
ctx0 giờ chỉ còn 7% chi phí của implementer. Phần lớn chi phí còn lại nhiều khả năng là output của tool dồn qua từng turn, như log e2e và ảnh chụp màn hình. Đây là giả thuyết, tôi chưa đo.
Trần maxTurns 40 quá thấp cho task dài. Ở lượt 2, 4 trong 5 luồng dừng với thông báo "completed without calling StructuredOutput". Nguyên nhân thật là 5 implementer chạm đúng trần 40 turn khi đang làm dở, đếm bằng message id trong transcript. 40 không phải trần của workflow: general-purpose trong cùng workflow chạy tới 138 turn.
5 lần chạm trần ra 4 luồng dừng vì một luồng có 2 implementer chạm trần, ở task 1 và task 5. Ở task 1, script gọi lại một lần bằng model mạnh hơn khi agent trả kết quả rỗng, và lần gọi lại đó cứu được; ở task 5 thì không, nên luồng dừng. 3 luồng khác mỗi luồng có 1 implementer chạm trần và dừng. Luồng thứ 5 chạy trọn tới khi gộp.
Task web ở lượt 1, với e2e 18,7 phút, đã dùng 39/40 turn. Tôi nâng trần lên 60 lúc 03:03 sau lượt 1, nhưng phiên điều phối lượt 2 mở lúc 02:20 vẫn cắt implementer ở 40 turn từ 07:41 tới 08:17, tức 4,5-5 giờ sau khi file agent đã sửa. Với trần 60, lượt 3 vẫn có 5 trong 45 implementer chạm trần (task màn hình web kèm e2e): 60 vẫn sát khi task có e2e. 3 bài học:
- Sửa agent trong plugin có thể không tới phiên đang chạy. Một phiên khác nhận ngay agent mới và bản sửa thân agent, còn phiên điều phối vẫn giữ trần cũ, và tôi chưa giải thích được vì sao. Theo docs, agent ở
~/.claude/agents/được theo dõi file nên sửa là có hiệu lực ngay, còn plugin chỉ nạp lúc mở phiên hoặc khi chạy/reload-plugins(plugin loading). Cách an toàn theo docs, tôi chưa tự thử: sửa xong thì chạy/reload-pluginshoặc mở lại phiên. - Script điều phối nên coi kết quả null là chạm trần và gọi lại "làm tiếp phần dở". Qua Agent tool thường, subagent chạm
maxTurnstrả output đánh dấu partial và phiên chính resume được agent đó, theo docs. Trong workflow, kết quả thành null; một issue cộng đồng mô tả đúng việc báo nhầm này (tôi chưa đọc được nội dung issue). Ở lượt 3, cả 5 implementer chạm trần 60 đều được phiên điều phối resume qua Agent tool và làm xong. - Thông báo lỗi không nêu nguyên nhân, phải đếm turn trong transcript mới thấy.
Agent thiếu luật repo. Lượt 1 có 3 lỗi Minor kiểu này: để lại CSS mồ côi dù luật có sẵn, dùng git stash để chứng minh test fail trước khi sửa, sửa fixture demo để khớp key mà một test mới bắt.
Ca git stash nguy hiểm nhất, vì stash dùng chung cho mọi worktree và phiên của repo: phiên khác pop là lấy mất thay đổi. Tôi thêm luật cấm git stash vào agent implementer, bắt chứng minh test fail bằng cách chạy test mới trước khi viết code. Trong 66 transcript subagent sau khi thêm luật có đúng 1 lần dùng git stash, ở phiên điều phối lượt 2 vẫn chạy định nghĩa agent cũ, nên chưa chứng minh được luật có tác dụng. Các phiên mở sau khi khởi động lại: 0 lần.
Người điều phối không biết agent mang sẵn gì. Phiên chính tưởng agent thiếu luật file tạm nên chép tay vào từng prompt, trong khi agent đã có luật đó sẵn. Bài học: phải liệt kê rõ cho phiên điều phối biết mỗi agent mang luật nào.
Gói diff cho reviewer phình. Script đóng gói diff gửi cho reviewer sinh gói 113-133 KB khi diff có dòng rất dài, ví dụ JSON một dòng. Hướng sửa tôi đề xuất (chưa làm): bỏ file dòng dài khỏi diff thường, in word-diff riêng.
Luật lệch giữa các agent. Để luật không lệch giữa các bản chép, thân agent sinh từ cùng một file luật chung bằng marker <!-- include: rules.md#Tên mục -->, script build báo lỗi nếu mục bị đổi tên. Include nguyên cả mục thì quá thô cho agent chỉ đọc: Explore nhận về luật ghi file mà nó không dùng được.
Sau lượt 2: ghi report từng bước và final review riêng
2 thay đổi tiếp theo sau lượt 2:
- Implementer giờ ghi report từ đầu và commit sau mỗi bước test xanh, để lượt sau đọc report và
git logrồi làm tiếp. Ý này giống bài về harness cho agent chạy dài của Anthropic: một file progress cùng lịch sử git để phiên mới biết việc đang ở đâu. Thay đổi này thêm vào khoảng 10:30 ngày 04/11. Tôi chưa đo riêng tác dụng, nhưng ở lượt 3 cả 5 implementer chạm trần đều làm xong sau khi resume, và phiên điều phối cho là nhờ luật này. - Một agent final review riêng (Opus, không nạp
CLAUDE.md, chỉ đọc) chạy canary song song vớigeneral-purpose. Ngưỡng để đổi sang agent này: bắt đủ mọi lỗi Critical và Important của bản cũ, chi phí giảm ít nhất 30%. Kết quả ở mục dưới.
Canary final review: agent riêng rẻ hơn 28% nhưng bỏ sót 1 lỗi Important
Canary chạy trên một nhánh của một side project (backend Go, web UI TypeScript), review sau khi xong mọi task. 3 bản nhận cùng gói review (diff, plan, ledger) và cùng prompt. Phiên của dự án đối chiếu từng finding với code.
| Bản | Important thật bắt được | Turn | ctx0 | cost_units | Thời gian |
|---|---|---|---|---|---|
general-purpose Opus (bản hiện tại) | 2/2 | 20 | 85,6k | 0,61M | 226 giây |
Agent final review riêng, Opus, không nạp CLAUDE.md | 1/2 | 27 | 9,5k | 0,44M (-28%) | 254 giây |
| Cùng agent riêng, Fable | 0/2 | 36 | 9,5k | 0,58M (-5%) | 397 giây |
Agent riêng trượt cả 2 ngưỡng. Nó bỏ sót 1 lỗi Important thật: một trường config ghi null hoặc ghi bằng chuỗi nhiều dòng gấp bị xếp vào mức ít đặc quyền hơn thực tế. Chi phí chỉ giảm 28%, thấp hơn ngưỡng 30%.
ctx0 nhỏ hơn (9,5k so với 85,6k) không tự trả lại ở đây. Không nạp luật repo từ đầu, agent mất thêm turn để đọc (27 so với 20), phần đó ăn gần hết khoản tiết kiệm và đi kèm một finding thật bị mất. Với implementer và reviewer từng task thì cách này vẫn có lãi, như các bảng ở trên. Giải thích của tôi cho khác biệt: final review cả nhánh chạm nhiều mục luật cùng lúc, mà tôi chưa tách riêng để đo giả thuyết này.
Fable cho final review không có lợi: 0 lỗi Important, bỏ sót cả 2 lỗi thật, chậm nhất, chi phí gần bằng Opus. Mỗi bản vẫn bắt được vài lỗi Minor thật mà 2 bản kia bỏ sót, nên ý kiến thứ hai có giá trị, chỉ chưa đủ để thay bản hiện tại.
Quyết định: final review giữ general-purpose Opus, agent riêng nằm trong kit và không dùng. Mẫu nhỏ: 1 nhánh, mỗi bản chạy 1 lần, 2 lỗi Important.
Lượt 3 chạy trọn: 4 chỗ còn tốn
- Trần turn giữ được việc, không giữ được chi phí. 5 trong 45 implementer (task màn hình web kèm e2e) chạm trần 60 turn. Phiên điều phối resume từng cái và việc xong nhờ luật ghi report sớm, commit sau mỗi bước xanh. Nhưng agent được resume giữ nguyên context đang phình, nên 5 task này chiếm 44% chi phí implementer; 2 task lớn nhất chạy khoảng 100 turn mỗi cái. Cách sửa: khi viết plan, tách task nào có thể cần hơn khoảng 40 turn.
- Fix loop phình phạm vi. Final review của một nhánh dẫn tới 5 vòng sửa, một vòng leo lên Opus, tổng khoảng 7M (khoảng 13% đợt chạy). Code là một parser viết tay đứng sau luật bảo mật "không bao giờ báo mức quyền thấp hơn thực tế". Mỗi lần re-review dò xa hơn và tìm ra thêm một dạng input lọt qua. Cái nào cũng là lỗi thật, nhưng mỗi cái mở thêm một vòng. Cách sửa đúng chỉ tới ở vòng 4: coi mọi input không đơn giản là mức đặc quyền cao nhất (fail-closed). Quy tắc rút ra: re-review chỉ kiểm lỗi của vòng trước, lỗi mới ghi vào ledger thay vì mở vòng mới; parser hoặc guard viết tay mà sang vòng 2 vẫn rò thì chuyển sang fail-closed, đừng vá từng dạng input.
- Việc phụ vẫn chạy ở agent nặng. Re-review sau final review và gộp nhánh chạy bằng
general-purpose, khởi động ở khoảng 87-90k context: khoảng 6M cho 6 lượt gọi. Agent gọn làm cùng việc ở khoảng 0,25M mỗi re-review. - Orchestrator là chi phí kế tiếp. Riêng orchestrator tốn 22,7M, khoảng 29% tổng chi phí đợt chạy (cộng với 56,9M của subagent). Context trung bình 219k, đỉnh 367k, 8 lần compact trong 5 giờ, vì một phiên giữ 4-5 plan song song. Tôi chưa đổi gì ở đây, còn là điểm mở.
Tôi gom 3 bài học đầu thành một luật chung cho mọi repo chạy plan bằng subagent: re-review có phạm vi chạy trên reviewer gọn, gộp nhánh chạy trên implementer gọn, chuyển sang fail-closed ở vòng 2, tách task quá khoảng 40 turn. Chưa đo tác dụng của luật này.
Chưa đo được: tổng tiết kiệm của cả hệ thống
3 lượt chạy cho thấy chi phí mỗi lượt gọi implementer và ctx0 giảm rõ; chất lượng lượt 1 đạt nhưng chưa có mốc cũ để so. Chúng chưa nói được tổng tiết kiệm của cả hệ thống. Lượt 2 không có số chất lượng đầy đủ vì 4 luồng dừng trước bước final review; luồng chạy trọn có 0 vòng sửa ở task của nó, ngoài ra không có thêm số. Lượt 3 chạy trọn 5 giờ, nhưng chi phí của orchestrator (22,7M) nằm ngoài các số mỗi lượt gọi ở trên. Số so 7 ngày trước và sau cho cả hệ thống có vào khoảng 11/11.
Cập nhật 11/11: số tổng 7 ngày trước và sau sẽ thêm vào đây.
Bài viết liên quan
tất cả bài viết → Trang nén Mac nhảy từ 5% lên 30% vì một vòng lặp chờ logMột subagent của Claude Code chờ log e2e bằng vòng lặp đọc /dev/zero. Một process bash phình tới 47,7 GB, số trang nén của Mac nhảy từ 5% lên 30% giới hạn trong khi RAM vẫn báo trống 71%.đọc tiếp →
 Mac còn 65% RAM vẫn sắp panic: bộ nén, IOSurface và WebKit của PlaywrightMac Studio 32 GB panic với 100% of compressed pages limit, rồi tối cùng ngày suýt panic lần hai khi RAM vẫn báo trống 65%. Thứ bị đầy là số trang trong bộ nén, và thủ phạm là IOSurface do WebKit của Playwright để lại trong kernel.đọc tiếp →
 REA: cho agent dịch ngược phần mềm, rồi kiểm luôn cái oracleREA cho coding agent đọc một chương trình không có source, xuống tới machine code, rồi dựng lại tính năng đó bằng code của mình. Bản dựng lại đúng hay sai do oracle quyết định, và oracle cũng là code, cũng có bug.đọc tiếp →
 Top 10 skill Claude Code nên cài, xếp theo sao GitHub: bộ nào làm gì, bộ nào đè lên nhau10 bộ skill cho Claude Code có nhiều sao GitHub nhất tại 29/10/2026: Superpowers, Matt Pocock Skills, Karpathy Skills, Anthropic Skills, Ponytail, UI UX Pro Max, Graphify, Caveman, Agent Skills, Taste Skill. Mỗi bộ có lệnh cài, việc nó làm và chỗ nó trùng với bộ khác.đọc tiếp →