blog
Template Fable 5.2 cho agent team: đo trên log của mình trước khi chép prompt
Một template prompt "Coding Agent Team" cho Fable 5.2 lan truyền trên X, khoảng 80% đã có sẵn trong setup của tôi. Phần còn lại tôi đo bằng ledger và report thật rồi mới quyết, và lỗi đáng sợ nhất tìm được lại nằm ở bảng giá, không ở prompt.
- Ngày đăng
Một template prompt cho Fable 5.2 đang lan truyền: lead điều phối, builder rẻ, reviewer đọc context sạch, brief giao việc có khung cố định. Khoảng 80% đã nằm sẵn trong setup của tôi. Tôi không chép nốt phần còn lại mà đo từng câu bằng ledger và report của chính mình, và kết quả là không thêm câu nào. Chỗ hỏng thật lại nằm ngoài prompt: bảng giá của công cụ theo dõi chi phí không biết model id mới.
Khoảng 80% template đã có sẵn
Đối chiếu từng ý với setup đang chạy:
- Lead điều phối, không tự code. Phiên chính giao việc theo plan, mỗi task một subagent.
- Builder dùng model rẻ. Subagent mặc định chạy Sonnet.
- Reviewer chỉ đọc, context sạch. Final review chạy Opus, ngoài ra có cross-review bằng Gemini cho nhánh sắp merge.
- Brief giao việc có Goal, Context, Done, Report, kèm trạng thái BLOCKED khi kẹt.
- Chỉ xong khi test pass.
Điểm tôi không theo là Agent Teams. Tài liệu ghi tính năng này còn experimental, tắt mặc định, và token tăng theo số teammate vì mỗi teammate là một phiên Claude Code riêng. Với việc tuần tự trên nhiều file chung, subagent rẻ hơn. Cách tôi cắt chi phí subagent nằm ở bài tối ưu subagent Claude Code.
Lỗi thật: bảng giá không có claude-fable-5-2
Công cụ theo dõi chi phí của tôi có 2 bảng tra theo model id: bảng giá và bảng context window. Cả 2 không có claude-fable-5-2. Hàm khớp model chỉ nhận id kèm hậu tố ngày hoặc hậu tố [...], nên id mới không khớp khoá nào.
Hậu quả là chi phí bị thiếu im lặng, không bị thổi lên. Kiểu lỗi này khó thấy hơn lỗi tính dư, vì số trông vẫn hợp lý. Chưa lượt dùng nào bị tính sai, vì chi phí tính lúc đọc: thêm id vào bảng là các lượt cũ có số đúng.
Giá để điền bảng lấy từ trang giá chính thức: Fable 5.2 là 8 USD input và 40 USD output mỗi triệu token, cache read 0,20 USD. Fable 5.1 là 10 USD và 50 USD.
Bài học không nằm ở một dòng trong bảng. Alias model đổi (fable giờ trỏ sang 5.2) thì mọi bảng tra theo model id phải soát lại: giá, context window, nhãn hiển thị, bất cứ chỗ nào so khớp chuỗi.
Canary: Fable 5.2 so với Opus ở final review
Cùng một diff khoảng 166 KB (tính năng bản tin sáng của công cụ điều hành, xem bài về job định kỳ), cùng prompt, tôi cho Opus và Fable 5.2 (effort high) chạy final review:
| Thời gian | Token | Critical | Important thật | Minor | |
|---|---|---|---|---|---|
| Opus | 2 phút 14 giây | ~117k | 0 | 1 | 5 |
| Fable 5.2 | 8 phút 18 giây | ~211k | 0 | 1 (cùng lỗi) | 12 |
Lỗi Important chung: khởi động lại đúng trong cửa sổ gửi thì bản tin gửi thiếu và mất luôn ngày đó. Fable 5.2 có nhiều minor thật hơn Opus, nhưng riêng Opus bắt một lỗi bookmark gây gửi đôi. Không bản nào báo sai Critical hay Important.
Kết luận: Fable 5.2 không bắt thêm lỗi nặng nào, tốn khoảng 3,7 lần thời gian và 1,8 lần token, nên final review vẫn giữ Opus. Đây chỉ là một canary, đừng đọc nó như một benchmark. Canary trước đó với Fable 5.1 (04/11) sót cả 2 lỗi Important thật.
Đo trước khi thêm "Finish the whole task" và "Owns:"
Hướng dẫn prompt cho Fable 5.2 của Anthropic có đoạn "Finish the whole task" cho trường hợp model dừng giữa chừng khi còn việc. Anthropic replay các phiên ở effort medium: có đoạn đó thì số phiên bỏ dở việc còn làm được giảm khoảng một nửa, đổi lại output token tăng khoảng 30%. Template còn thêm trường Owns: cho mỗi task để tránh đụng file.
Số đó đo ở medium, còn implementer của tôi chạy Sonnet, nên tôi đếm trên log của mình thay vì tin số của người khác:
- Bỏ dở vì trở ngại thường: đếm 52 ledger của subagent-driven-development (file ghi tiến độ từng task, từ 31/10 đến 09/11) và 553 report của worker. Kết quả 0 lần bỏ dở để hỏi "làm tiếp không".
- Chạm trần lượt: 7 lần, 4 lần ở trần 60 và 3 lần ở trần 80. Cả 7 đều resume xong.
- Conflict khi merge: 13 trong 118 lần merge, và đều rơi vào những file mọi task đều chạm hợp lệ như
app.css,sw.js,AGENTS.md. KhaiOwns:không chặn được, vì các task vốn cùng sửa file đó.
Vấn đề mà câu đó giải không xảy ra ở setup này, nên tôi không thêm 2 câu, khỏi trả 30% output token. Cái cần xử là trần lượt: task nào chạm trần thì tách nhỏ hơn, mục tiêu khoảng 40 lượt mỗi task.
"This codebase is yours" không nên là mặc định
Một câu khác trong template: nói với model rằng codebase là của nó. Theo cùng tài liệu, câu này khiến model gộp code lặp và sửa vấn đề liền kề mà không ai yêu cầu: khoảng một nửa số lần thử, so với dưới một phần mười khi không có câu. Cái giá là khoảng 1,5 lần output token, cứ 6 đến 10 lần lại có một lần đổi hành vi một tính năng sẵn có ngoài yêu cầu, và tóm tắt cuối hay sót thay đổi nhỏ.
Với repo của khách, thứ tôi cần là diff nhỏ và đọc được, nên không dùng câu này mặc định. Dùng khi chính mình sở hữu repo và muốn model dọn cấu trúc, rồi đọc diff chứ không chỉ đọc tóm tắt.
Luật cẩn trọng tích tụ làm model xin duyệt thừa
Tài liệu mô tả một kiểu hỏng khác: các luật "đừng làm X" tích tụ trong file luật và memory, rồi model xin duyệt cả việc không cần. Chi tiết đáng nhớ là ngoại lệ phải viết ngay trong câu luật. Trong thử nghiệm của Anthropic, một dòng riêng kiểu "bước đã duyệt thì được làm" gần như không đổi tỉ lệ (khoảng 1 trên 10 lần), còn khi chính câu luật nói cần duyệt trước thì model làm bước đó khoảng 9 trên 10 lần.
Tôi chạy /claude-api prompt-audit trên bộ luật của mình và nó chỉ ra một mâu thuẫn. Một luật nói thiếu dữ kiện thì dừng hỏi. Luật khác nói khi tôi vắng thì làm tiếp. Gặp lúc vắng và thiếu dữ kiện, model kẹt giữa 2 luật. Cách gỡ: phần thiếu dữ kiện thì chờ, làm nốt phần không phụ thuộc, câu hỏi đặt lên đầu báo cáo.
Brief cho worker chạy khi tôi vắng cũng sửa theo hướng đó. Thay vì "cứ làm cẩn thận", brief ghi rõ việc nào đã được duyệt: commit trong worktree, chạy lệnh test, thử lại lệnh chỉ đọc. Worker chạy permission mode auto, gặp chốt chặn thì co lại, nên câu chung chung không đủ.
Chế độ trả lời nén không áp cho báo cáo
Tôi bật chế độ trả lời nén (caveman) cho chat để đỡ token. Chat nén được, báo cáo thì không: báo cáo cuối sau việc dài và report mà subagent gửi về là thứ người đọc không thấy các tool call phía sau. Hướng dẫn của Anthropic cũng nhắm vào đúng chỗ này (Make reports easy to follow): viết câu đủ, đưa ý chính vào vài câu đầu. Luật của tôi là kết quả chính trước, rồi đã đổi gì, chưa kiểm gì, việc tiếp theo.
Effort: bắt đầu ở high
Anthropic khuyên bắt đầu ở high, và ghi nhận ở xhigh trở lên Fable 5.2 hay dùng subagent để tự soát việc của mình. Subagent chạy Fable trong setup của tôi nhận effort: high truyền tường minh, vì effort mặc định của phiên chính cao hơn.
Quy trình cho lần sau
Gặp một template prompt hay, tôi làm theo 3 bước:
- Đối chiếu từng ý với thứ đang chạy. Phần trùng thì bỏ.
- Tìm lỗi nằm ngoài prompt. Model mới thường làm hỏng thứ không ai nghĩ tới, như bảng tra theo model id.
- Đo từng câu muốn thêm trên log của mình, rồi so với chi phí của câu đó. Câu nào giải vấn đề chưa xảy ra thì không chép.
Giới hạn của cách này: số của tôi đo ở một setup (Sonnet implementer, trần lượt 60 đến 80), một canary, một khoảng thời gian ngắn. Nó không bác bỏ số của Anthropic, chỉ cho biết vấn đề họ mô tả chưa xuất hiện ở đây.
Bài viết liên quan
tất cả bài viết →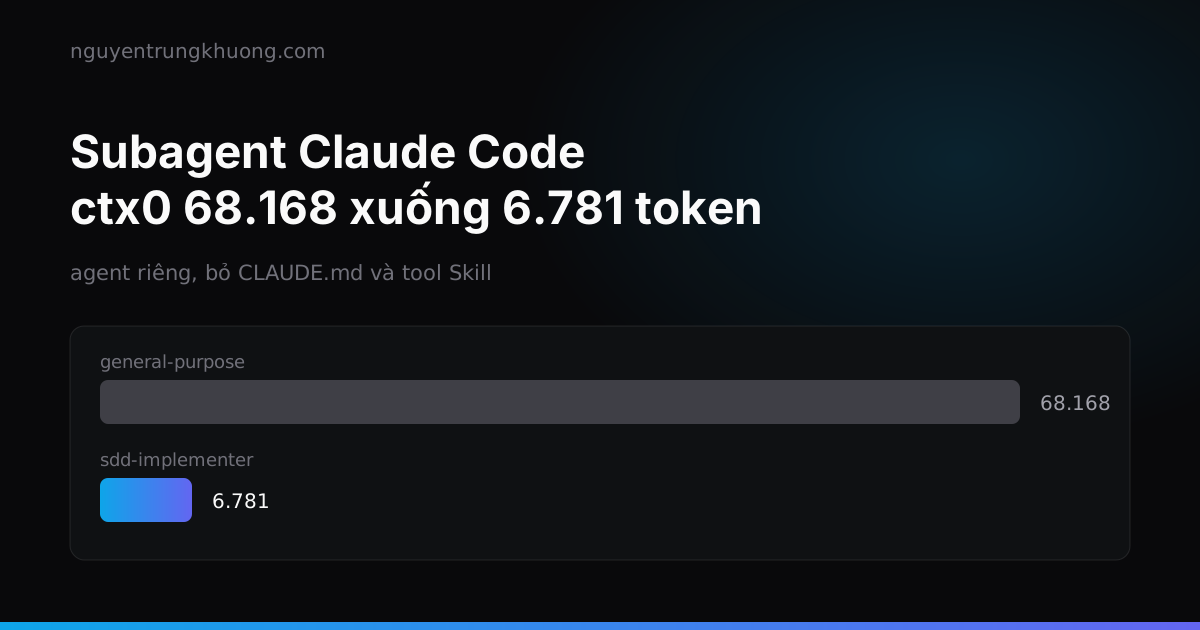 Tối ưu subagent Claude Code: cắt 40-78% chi phí mỗi lượt gọi implementerSubagent đắt vì mỗi lần khởi động nạp hàng chục nghìn token luật và skill, rồi lặp lại qua hàng chục turn. Tôi đo bằng transcript, thay bằng agent riêng, rồi đối chiếu qua 3 lượt chạy subagent-driven-development thật.đọc tiếp →
 Job định kỳ báo qua Telegram: vì sao tin quan trọng nhất lại mất im lặngSoát lại các job launchd và công cụ điều hành của mình theo 6 nguyên tắc tự động hoá agent của Anthropic, tôi thấy cùng một lỗi lặp ở mọi script: hàm gửi tin luôn trả thành công, rồi trạng thái tiến lên dù tin chưa tới. Đây là cách sửa, cách test nhánh lỗi, và heartbeat để biết job còn chạy.đọc tiếp →
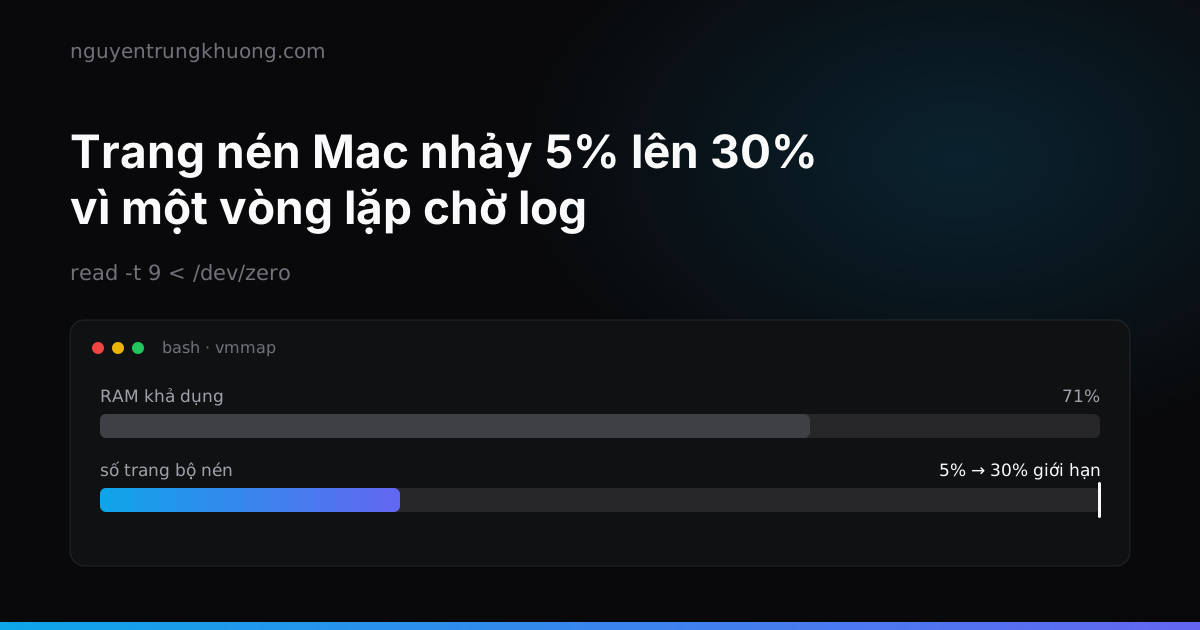 Trang nén Mac nhảy từ 5% lên 30% vì một vòng lặp chờ logMột subagent của Claude Code chờ log e2e bằng vòng lặp đọc /dev/zero. Một process bash phình tới 47,7 GB, số trang nén của Mac nhảy từ 5% lên 30% giới hạn trong khi RAM vẫn báo trống 71%.đọc tiếp →
 Mac còn 65% RAM vẫn sắp panic: bộ nén, IOSurface và WebKit của PlaywrightMac Studio 32 GB panic với 100% of compressed pages limit, rồi tối cùng ngày suýt panic lần hai khi RAM vẫn báo trống 65%. Thứ bị đầy là số trang trong bộ nén, và thủ phạm là IOSurface do WebKit của Playwright để lại trong kernel.đọc tiếp →