blog
Job định kỳ báo qua Telegram: vì sao tin quan trọng nhất lại mất im lặng
Soát lại các job launchd và công cụ điều hành của mình theo 6 nguyên tắc tự động hoá agent của Anthropic, tôi thấy cùng một lỗi lặp ở mọi script: hàm gửi tin luôn trả thành công, rồi trạng thái tiến lên dù tin chưa tới. Đây là cách sửa, cách test nhánh lỗi, và heartbeat để biết job còn chạy.
- Ngày đăng
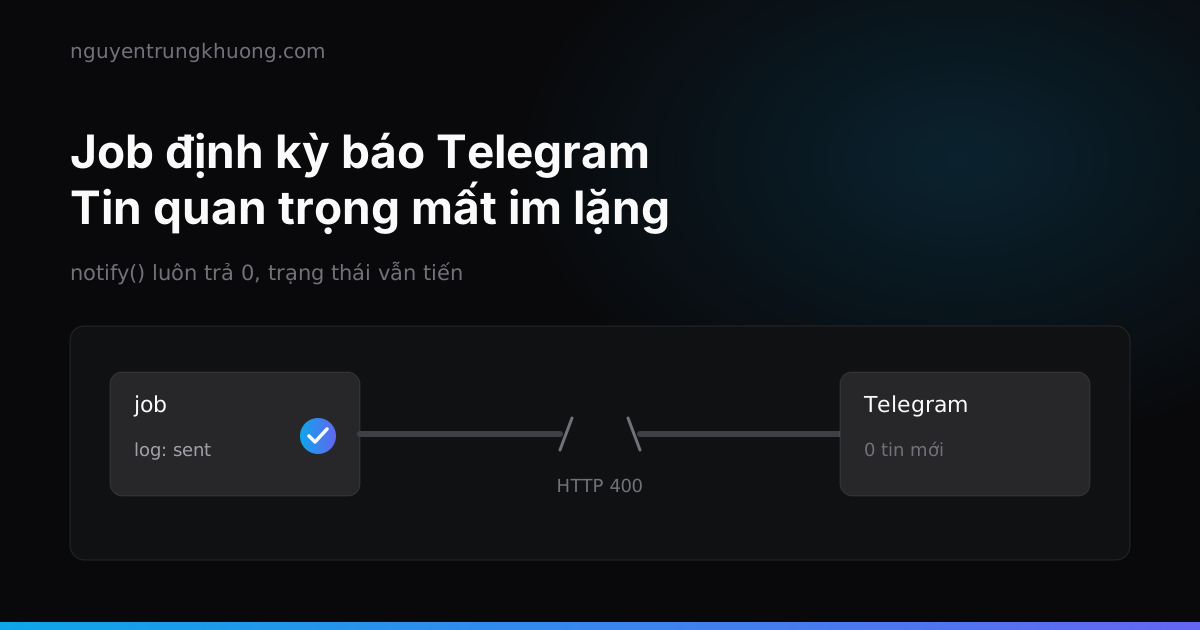
Job định kỳ gửi cảnh báo qua Telegram hay hỏng ở đúng một chỗ: hàm gửi tin luôn báo thành công, rồi script ghi trạng thái "đã báo" dù tin chưa tới. Lần sau job thấy trạng thái đã tiến nên không gửi lại. Tôi tìm thấy lỗi này ở mọi script shell của mình và ở 2 chỗ trong công cụ điều hành viết bằng Go. Bài này là cách tôi sửa, cách test nhánh lỗi, và 2 thứ thêm vào sau đó: heartbeat cho từng job và một bản tin sáng soạn bằng code, không cần gọi LLM.
Bối cảnh: một máy Mac, nhiều job nhỏ
Trên máy Mac làm việc, tôi có một loạt job launchd chạy theo lịch:
- Một job canh bộ nhớ kernel, báo trước khi máy sắp panic.
- Một job quét lỗ hổng plugin WordPress hằng tuần.
- Một job kiểm tra uptime các site, vài phút một lần.
- Một job đo PageSpeed hằng tuần và báo khi điểm tụt.
- Một job kéo bản sao lưu từ server về.
- Một job đồng bộ mã nguồn plugin tham khảo.
Ngoài ra còn một công cụ điều hành tự viết, chạy nền, theo dõi các phiên Claude Code, trạng thái CI và cảnh báo khi lộ khoá bí mật. Tất cả đều báo về Telegram.
Ngày 10/11/2026 tôi đối chiếu từng job với 6 nguyên tắc trong bài Building effective agent automations của Anthropic. Bài mô tả một agent chạy định kỳ, đọc Slack và GitHub rồi đăng bản tin lên Slack, nhưng 6 nguyên tắc áp được cho mọi job chạy không người trông:
- Đọc từng nguồn theo bookmark, không theo cửa sổ thời gian cố định như "24 giờ qua".
- Nguồn đọc lỗi thì báo "không đọc được", không báo như ngày yên tĩnh.
- Kiểm lại từng mục ngay trước khi gửi.
- Chỉ tính là đã gửi khi đích xác nhận, rồi mới cập nhật bookmark.
- Đọc lại preferences mỗi lượt từ nơi agent không sửa được, không nhúng cứng trong script.
- Quyền chỉ đọc ở chỗ chỉ cần đọc, và đặt trần chi phí cho mỗi lượt chạy.
Nguyên tắc 4 là chỗ gần như mọi job của tôi đều sai.
Lỗi chung: notify() luôn trả 0
Mọi script shell của tôi đều có một hàm notify() na ná nhau:
notify() {
  local token
  token=$(security find-generic-password -s telegram-bot -w 2>/dev/null) || return 0
  curl -s -X POST "https://api.telegram.org/bot${token}/sendMessage" \
    -d chat_id="$CHAT_ID" --data-urlencode text="$1" >/dev/null || log "notify failed"
}
Nhìn qua thì ổn. Thực tế hàm này không bao giờ trả lỗi:
- Không lấy được token thì
return 0. curlkhông có-f, nên Bot API trả HTTP 400 hay 401 thìcurlvẫn thoát 0.- Không ai đọc trường
"ok"trong JSON trả về. - Lỗi mạng bị
|| lognuốt, vàlogthì thoát 0.
Phía gọi viết như sau:
notify "KHẨN: bộ nhớ kernel sắp chạm ngưỡng"
echo "$new_level" > "$STATE_DIR/level"
log "sent level $new_level"
Tin gửi hỏng, trạng thái vẫn tiến, log vẫn ghi "sent". Ai đọc log sau đó cũng tin là tin đã tới.
Hậu quả khác nhau theo từng job
Cùng một lỗi nhưng hậu quả tuỳ trạng thái mà job ghi:
| Job | Trạng thái ghi sau notify | Tin hỏng thì sao |
|---|---|---|
| Canh bộ nhớ kernel | Mức cảnh báo đã báo trong lần boot này | Tin KHẨN "sắp panic" không bao giờ báo lại cho tới khi khởi động lại máy |
| Quét lỗ hổng plugin | Thêm lỗ hổng vào seen.txt | Mất tin vĩnh viễn |
| Uptime | Mốc last đặt trước cả khi gửi | Tin "site down" đầu tiên mất, chỉ biết ở lượt nhắc sau |
| PageSpeed tuần | Bookmark ngầm là thư mục tuần trước, luôn tiến | Mức tụt điểm của tuần đó không báo lại |
Job nặng nhất là job chống panic: nó tồn tại chỉ để gửi đúng một tin vào đúng lúc, và đó là tin dễ mất nhất.
Cách sửa: trả lỗi khi chưa chắc tin đã tới
Bản rút gọn của hàm sau khi sửa trả khác 0 khi tin chưa chắc tới, và phía gọi chỉ ghi trạng thái khi hàm trả 0:
notify() {
  local token resp code
  token=$(security find-generic-password -s telegram-bot -w 2>/dev/null) || return 1
  resp=$(curl -sS -w '\n%{http_code}' -X POST \
    "https://api.telegram.org/bot${token}/sendMessage" \
    -d chat_id="$CHAT_ID" --data-urlencode text="$1") || return 1
  code=${resp##*$'\n'}
  [ "$code" = "200" ] || return 1
  case "${resp%$'\n'*}" in *'"ok":true'*) return 0 ;; esac
  return 1
}

if notify "KHẨN: bộ nhớ kernel sắp chạm ngưỡng"; then
  echo "$new_level" > "$STATE_DIR/level"
  log "sent level $new_level"
else
  log "send failed, level kept at $old_level"
fi
Gửi hỏng thì lượt sau job thấy trạng thái cũ và tự gửi lại. Đổi lại có thể nhận tin đôi khi Telegram đã nhận mà phản hồi bị mất trên đường về. Với cảnh báo, nhận đôi một tin còn hơn mất nó.
Cùng lỗi có ở cả service Go. Cảnh báo lộ khoá ghi cờ notified[key] = true trước khi gửi, còn hàng chờ gửi nằm trong bộ nhớ, thử 3 lần rồi bỏ, daemon khởi động lại là mất hàng. Bản sửa ghi một event "đã báo" chỉ khi Telegram trả ok. Lỗi 4xx hay tràn hàng tính vào trần 5 lần, còn lỗi mạng, 429 và 5xx thì không tính và để lượt quét sau gửi lại.
Nguồn lỗi không phải ngày yên tĩnh
Nguyên tắc 2 bắt được một nhóm lỗi khác: job không đọc được nguồn nhưng lại xử như không có gì để báo.
- Job quét lỗ hổng thiếu API key thì
exit 3ngay, trước cả bước đếm lỗi. Bộ đếm "3 tuần liền lỗi mới báo" không bao giờ chạy tới. - Job uptime gặp lúc máy Mac mất mạng thì bỏ qua lượt đó, không đếm. Mất mạng cả buổi cũng không ai biết là uptime không được kiểm.
- Job PageSpeed bỏ qua exit code của lệnh đo. URL đo lỗi biến khỏi bảng tổng hợp, được coi là "không tụt", và tuần sau mốc so sánh thành bản thiếu.
- Job đồng bộ plugin tải hỏng vì mạng thì ghi plugin đó là "paid or custom", lẫn với plugin trả phí thật.
- Công cụ điều hành gọi
gh run listlỗi (kể cảghchưa đăng nhập) thì giao diện hiện "không có CI", trông y như repo không có workflow nào.
Cách sửa chung là phân biệt 2 trạng thái rõ ràng:
- Không có gì: im lặng là đúng.
- Không đọc được: đếm số lượt lỗi liên tiếp, chạm ngưỡng thì báo một dòng "nguồn X không đọc được", và giữ nguyên bookmark để lượt sau đọc lại từ chỗ cũ. Ngưỡng của tôi là 3 lượt liên tiếp.
Với job tải file, mã HTTP là đủ để phân biệt: 404 hoặc 410 mới là "không có bản công khai", còn 000, 5xx hay file zip hỏng là tải hỏng, giữ bản cũ và để lượt sau thử lại.
Test nhánh lỗi, không chỉ nhánh vui
Lỗi này sống lâu vì không ai từng chạy nhánh gửi hỏng. Bật "không gửi thật" khi test thường chỉ là SEND=0, và nhánh đó cũng trả 0. Tôi thêm vào mỗi script một biến giả lập có 3 giá trị:
case "${NOTIFY_SEND:-real}" in
  ok)   return 0 ;;
  fail) return 1 ;;
esac
Rồi chạy job trong một HOME tạm, với lệnh nguồn giả qua PATH, và kiểm đúng 2 điều:
- Gửi hỏng thì trạng thái giữ nguyên, và lượt sau gửi lại.
- Gửi được thì trạng thái tiến đúng một lần, và lượt sau không gửi lặp.
Với bộ đếm lỗi nguồn: nguồn hỏng tới lượt thứ 3 mới báo, báo hỏng thì lượt sau báo lại, rồi im cho tới khi nguồn đọc được.
Heartbeat: biết job còn chạy
Sửa xong nguyên tắc 4 vẫn còn một lỗ: job không chạy thì không gửi gì, và im lặng đó trông y như ngày bình yên. launchd nạp hỏng, máy tắt qua đêm, script lỗi cú pháp sau một lần sửa, đều cho cùng kết quả.
Quy ước heartbeat của tôi là một file một dòng cho mỗi job:
~/.local/state/heartbeat/<job>
<unix_time> <ok|fail> <every_seconds>
Job ghi file này bằng trap ... EXIT, nên thoát giữa chừng cũng ghi. Thoát khác 0 hoặc gửi Telegram hỏng thì ghi fail. Công cụ điều hành đọc thư mục này và coi một job là trễ khi đã quá 1,5 lần every_seconds chưa ghi. Hệ số 1,5 chừa chỗ cho Mac ngủ hay launchd chạy bù muộn.
Bản tin sáng không cần LLM
Phần lợi lớn nhất về chi phí không nằm ở sửa lỗi. Trước đây, mỗi sáng tôi hỏi phiên Claude Code điều phối "còn việc gì treo". Phiên đó chạy Opus trên một context đã lớn, và câu trả lời tốn đúng bằng chừng đó token cho một việc mà dữ liệu đã nằm sẵn trong database của công cụ điều hành.
Giờ công cụ tự soát bản tin bằng code và gửi Telegram lúc 07:30:
- Thẻ đang chờ duyệt.
- Checkbox còn mở trong các plan, theo từng repo.
- Worktree bị bỏ, nhánh chưa push.
- Cross-review chưa có kết luận.
- Quota và mốc reset.
- Job có heartbeat trễ hoặc
fail.
Bản tin cũng theo 6 nguyên tắc: mỗi nguồn có bookmark riêng; nguồn lỗi in một dòng "không đọc được lượt này"; bookmark chỉ tiến khi Telegram trả ok; giờ gửi và danh sách nguồn đọc từ setting. Lần gửi thử đầu tiên ra 38 mục, đủ để thấy trước đây mình đã để sót bao nhiêu việc nhỏ.
Đây là ý "script trước, AI khi cần": việc nào có dữ liệu cấu trúc và quy tắc rõ thì code làm, rẻ và lặp lại được. LLM để cho phần cần đọc hiểu. Code của bản tin này cũng là diff tôi dùng để so Fable 5.2 với Opus ở bước final review, kết quả nằm trong bài về template Fable 5.2.
Không chuyển lên cloud
Bản tham chiếu trong bài của Anthropic chạy trên Claude Managed Agents (beta) và đặt trần chi phí mỗi lượt bằng USD. Tôi giữ mọi thứ trên máy Mac vì 3 lý do: dữ liệu, khoá bí mật và mạng nội bộ đều ở máy; chi phí hiện nằm trong gói thuê bao đang dùng, còn agent cloud tính theo mức dùng; và các lỗi tìm được ở trên đều nằm trong logic của script, chuyển chỗ chạy không sửa được lỗi nào.
Checklist cho mọi job định kỳ
- Hàm gửi trả khác 0 khi thiếu token, lỗi mạng, HTTP khác 200, hoặc JSON không có
"ok":true. - Trạng thái (bookmark,
seen, mức cảnh báo) chỉ ghi sau khi gửi được. - Log ghi kết quả thật, không ghi "sent" trước khi biết.
- Không đọc được nguồn thì đếm, chạm ngưỡng thì báo, giữ bookmark.
- Có biến giả lập gửi
ok/failvà test cả 2 nhánh. - Ghi heartbeat bằng
trap EXIT, cóevery_seconds. - Danh sách host, giờ gửi, ngưỡng đọc từ file cấu hình.
- Việc soạn được bằng code thì đừng gọi LLM.
Đánh đổi còn lại
Gửi lại khi chưa chắc đồng nghĩa với thi thoảng nhận tin đôi, và tôi chấp nhận. Heartbeat chỉ bắt được job đã ghi ít nhất một lần: job chưa từng ghi thì công cụ không biết nó tồn tại. Muốn chặn cả lỗ đó thì cần một danh sách job bắt buộc, và tôi để việc đó lại sau.
Bài viết liên quan
tất cả bài viết → Template Fable 5.2 cho agent team: đo trên log của mình trước khi chép promptMột template prompt "Coding Agent Team" cho Fable 5.2 lan truyền trên X, khoảng 80% đã có sẵn trong setup của tôi. Phần còn lại tôi đo bằng ledger và report thật rồi mới quyết, và lỗi đáng sợ nhất tìm được lại nằm ở bảng giá, không ở prompt.đọc tiếp →
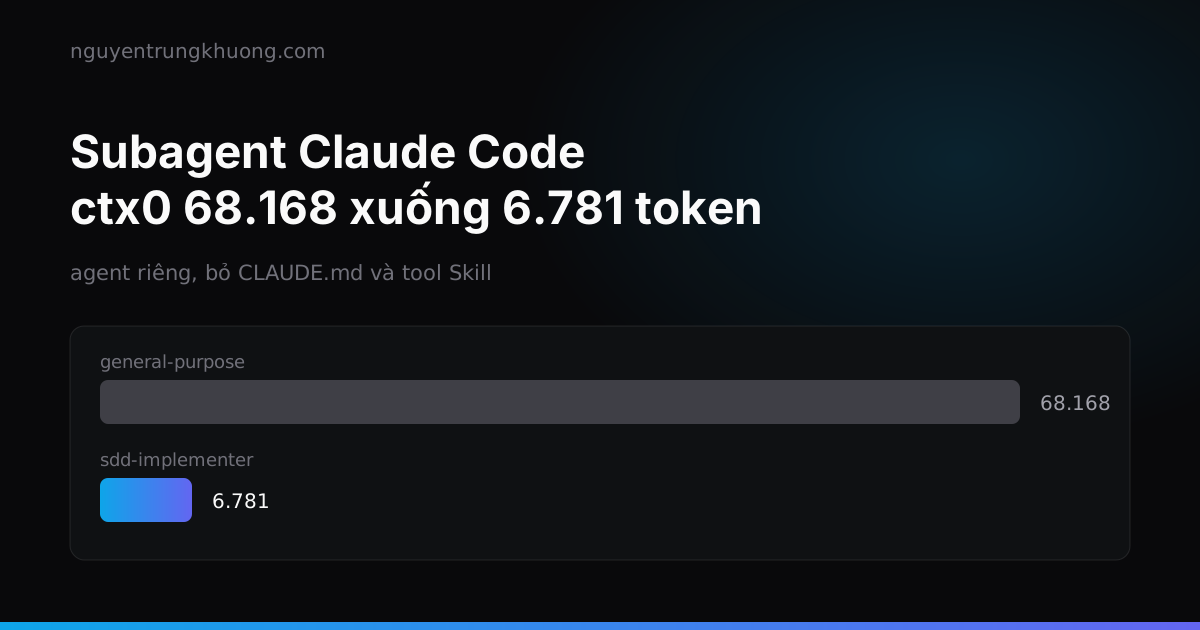 Tối ưu subagent Claude Code: cắt 40-78% chi phí mỗi lượt gọi implementerSubagent đắt vì mỗi lần khởi động nạp hàng chục nghìn token luật và skill, rồi lặp lại qua hàng chục turn. Tôi đo bằng transcript, thay bằng agent riêng, rồi đối chiếu qua 3 lượt chạy subagent-driven-development thật.đọc tiếp →
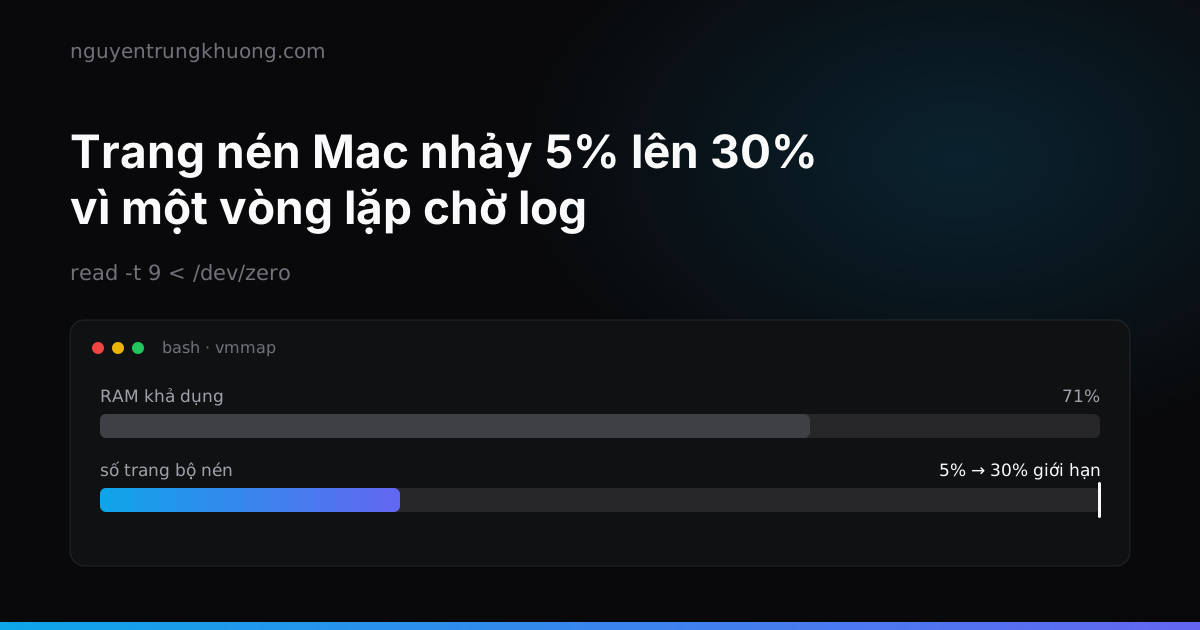 Trang nén Mac nhảy từ 5% lên 30% vì một vòng lặp chờ logMột subagent của Claude Code chờ log e2e bằng vòng lặp đọc /dev/zero. Một process bash phình tới 47,7 GB, số trang nén của Mac nhảy từ 5% lên 30% giới hạn trong khi RAM vẫn báo trống 71%.đọc tiếp →
 Mac còn 65% RAM vẫn sắp panic: bộ nén, IOSurface và WebKit của PlaywrightMac Studio 32 GB panic với 100% of compressed pages limit, rồi tối cùng ngày suýt panic lần hai khi RAM vẫn báo trống 65%. Thứ bị đầy là số trang trong bộ nén, và thủ phạm là IOSurface do WebKit của Playwright để lại trong kernel.đọc tiếp →